레이블이 통계인 게시물을 표시합니다. 모든 게시물 표시

2022년 5월 10일 화요일

Orange3에서 Logistic Regression 분류

0. 혼자 공부하는 머신러닝+딥러닝에 있는 fish.csv 자료를 이용하여(이곳에서 다운로드) Logistic Regression 분류를 해봅니다.

1. 오렌지의 캔바스를 아래와 같이 구성하고 


2. File Widget을 선택하여 다운받은 파일을 지정하고 >  [Reload] 버튼을 선택합니다.


3. Data Sampler Widget을 선택하여 훈련(Train)데이타(85%)와 검증(Test)데이타(15%)로 분류합니다.


4. Test Prediction 과 Data Table을 선택하여 결과를 확인합니다. 


5. Data Table에서 Feature 클라스별로 계수가 있음을 확인하시고, Test Prediction 의 왼쪽 박스에서 계산결과를 확인합니다. 가장 높은 것으로 분류합니다. 이 계수를 딥러닝에서 조절해 가면서 학습을 한다고 생각하면 편합니다.


2022년 5월 9일 월요일

ROC 곡선의 이해 (Receiver Operating characteristic Curve)

 1. 오차행렬 구성

돌아서면 잊버버리는 표입니다. 예측은 양성(P), 음성(N)으로 하고, 실제결과는 맞음(T), 틀림(F)로 기억하면 쉽더군요. 부호표시는 뒤에서부터합니다.
양성이라고 예측했는데 양성으로 맞았으니(TP = A), 틀렸으면(FP)
음성이라고 예측했는데 음성으로 맞았으니(TN = B), 틀렸으면(FN)

2. 민감도(Sensitivity = Recall)
민감도는 '실제 양성 대 맞춘 양성의 비율'을 의미한다. 
위에서 실제 양성인 것은 TP와 FN이다. 양성으로 예측해서 맞췄거나 음성으로 예측했는데 틀린 경우를 합친 것이 실제 진단 결과가 양성인 것이 된다. 
그리고 여기서 맞춘 양성은 TP만 해당하므로 이를 비율로 표현한 민감도는 다음과 같이 구해진다.

3. 특이도(Specificity)
특이도는 '실제 음성 대 맞춘 음성의 비율'을 의미한다. 
위에서 실제 음성인 것은 TN과 FP이다. 음성으로 예측해서 맞췄거나 양성으로 예측했는데 틀린 경우를 합친 것이 실제 진단 결과가 음성인 경우에 속한다. 
그리고 여기서 맞춘 음성은 TN만 해당하므로 이를 비율로 표현한 특이도는 아래와 같이 계산된다.

4. ROC곡선(Receiver Operating characteristic Curve)
위양성률(1-특이도)을 x축으로, 그에 대한 실제 양성률(민감도)을 y축으로 놓고 그 좌푯값들을 이어 그래프로 표현한 것이다. 일반적으로 0.7~0.8 수준이 보통의 성능을 의미한다. 
0.8~0.9는 좋음, 0.9~1.0은 매우 좋은 성능을 보이는 모델이라 평가할 수 있다. (사족: X축은 적을수록 좋고 Y축은 클수록 좋다, 즉 같은 TP 가로로 수평선을 그렸을때 FP가 적을 수록(1<2<3 정확하겠죠, 수직선을 그은 다면 TP가 클수록(4<5<6) 정확하겠지요)
5. 정확도(Accuracy)
전체 데이터에서 모델이 옳게 판단한 비율

6. 오렌지3에서의 ROC 위젯예제,  File자료는 iris입니다.


7. Test and Score


8. Precision 정밀도(양성이라고 판단한 것중 양성의 비율 = 정밀한 의사 겠지요)

8. AUC의 의미
AUC는 'Area Under Curve'의 약자로 ROC분석을 통해 그려지는 '곡선 밑의 면적'을 의미한다.  AUC는 0.5보다 커야 하고 AUC 면적이 클수록 해당 검사모델의 정확도가 높다

9. settosa의 정확도 = 0.942


10. versicolor의 정확도 = 0.482, ROC 곡선은 왼쪽위 상단에 붙어야 정확도가 있는 모델이다.


2022년 5월 7일 토요일

오즈비 (Odds Ratio = 승산비)에서 로지스틱으로

1. 오즈비 

사건이 발생할 확률이 발생하지 않을 확률에 비해 몇배 더 높은가를 설명하는 개념

 이미지 출처 : https://m.blog.naver.com/y4769/221851780608

2. 오즈비 계산 예

A : 97명 - 코로나 환자와 접촉 후, 코로나에 감염됨
B : 307명 - 코로나 환자와 접촉 후, 코로나에 감염되지 않음
C : 200명 - 코로나 환자와 접촉하지 않았지만, 코로나에 감염됨
D : 1409명 - 코로나 환자와 접촉하지 않았고, 코로나에 감염되지 않음

Odds Ratio(OR) = 136673 / 61400 = 2.2로 계산된다.

따라서, 코로나 환자와 접촉한 사람은 접촉하지 않은 사람보다 코로나 감염이 될 가능성이 2.2배 높다고 할 수 있다.

3. 로짓(logit) 변환: 오즈비에 log 함수 적용한 것으로 로짓을 대상으로 회귀분석을 적용한 것이 로지스틱 회귀분석이 된다.

logit = log( p / 1-p )

2022년 5월 5일 목요일

카이제곱 검정의 적합도 검정(예제)

 카제곱 검정의 독립성 검정은 이곳에서 살펴 보았는데 적합성 검정은 오렌지에서는 찾기 힘들어 파이썬스크립트를 사용해야만 할 것 같음. 아래 예제는 유의수준 5%임.

1.   귀무가설: H0 : 6가지의 상황에서 기대값이 같을 것이다.

      대립가설(연구가설): H1 : 어느 하나는 다르다.

import scipy.stats as ss
xo = [16, 18, 16, 14, 12, 12]
ss.chisquare(f_obs= xo)

Power_divergenceResult(statistic=2.0, pvalue=0.8491450360846096)

귀무가설을 기각 할 수 없다. 어느 하나의 상황도 다른 것들과 다르다고 볼 수 없다.

2. 귀무가설: H0 : 6가지의 상황에서 기대값이 같을 것이이다.

     대립가설(연구가설): H1 : 기대 값과 다른 어느하나가 있다.

import scipy.stats as ss

xo = [16, 18, 16, 14, 12, 12]
xe = [16, 16, 16, 16, 16, 8]
ss.chisquare(f_obs= xo, f_exp= xe)

Power_divergenceResult(statistic=3.5, pvalue=0.6233876277495822)

귀무가설을 기각 할 수 없다. 어느 하나의 상황도 기대값에 벗어 났다고 볼 수 없다.

3. 

import scipy.stats as ss
xo = [324, 78, 261]
xe = [371, 80, 212]
ss.chisquare(f_obs = xo, f_exp= xe)

Power_divergenceResult(statistic=17.329649595687332, pvalue=0.00017254977751013492)

귀무가설을 기각한다. 3개의 상황중 적어도 하나는 기대값에 벗어 났다.

4. 학습할 경우 주의할 사항은 관측값의 합계와 기대값의 합계는 같아야 합니다. (당연한데 햇갈립니다)

5. 독립성검정은 아래와 같은 방법도 가능합니다.

import pandas as pd
import scipy.stats as ss

x = [[269, 83, 215], [155, 57, 181]]
df= pd.DataFrame(x)
ss.chi2_contingency(df)

(7.094264414804222, 0.028807134195296135, 2, array([[250.425 , 82.6875, 233.8875], [173.575 , 57.3125, 162.1125]]))

귀무가설을 기각한다. 1의 환경(남자)과 1의 환경(여자)의 상품 1 ,2, 3의 소비형태가 차이가 있다.

2022년 4월 29일 금요일

Orange3로 통계강의 따라하기 05 (비율검정 카이제곱 chi2)

 Orange3를 엘리쌤과 인공지능에서 알게된후 Python 기초 통계를 공부하면서 최대한 Orange3로 따라하면서 통계도 공부하고, 오렌지도 공부하고 덩달아 파이썬도 익히는 시간을 갖기로 하였습니다.

섹션: 카이제곱(chi2)을 오렌지로 따라해봅니다.

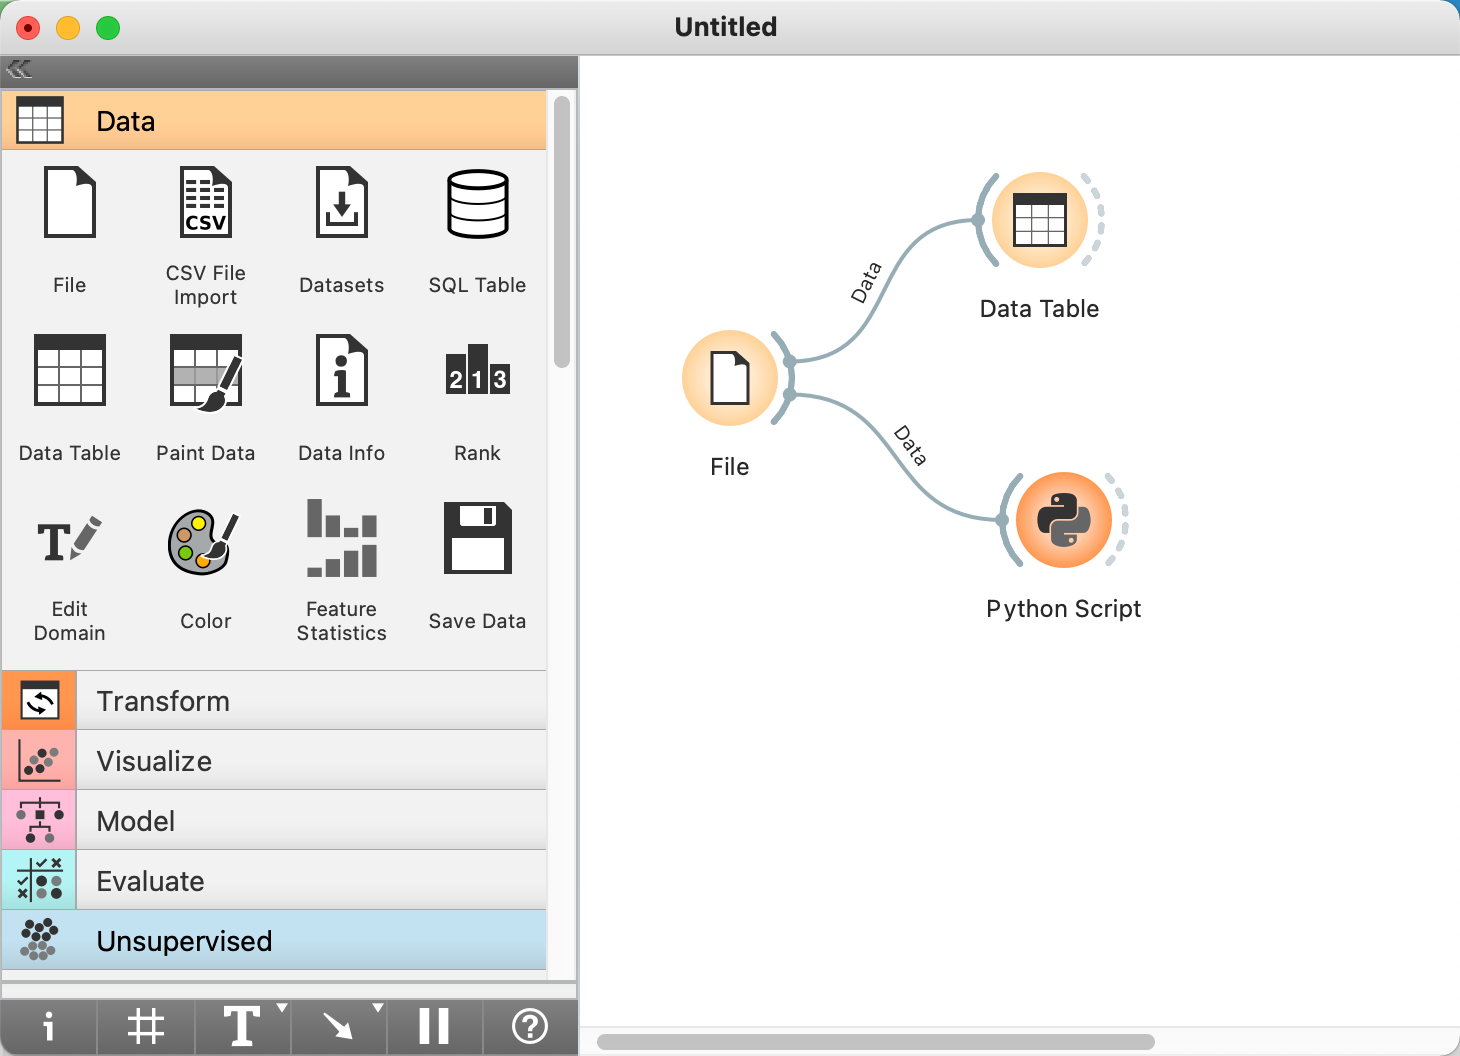
1. 데이터는 아래와 같은 형태로 housetasks.tab 이것을 다운로드하고, 오렌지의 캔바스를 아래와 같이 배치하고 연결합니다.


2. File Widget으로 다운받은 파일을 불러오고, Python Widget을 더블크릭하고 아래 내용을 복사하여 붙여넣기 합니다.

import Orange.data.pandas_compat as p
idf = p.pd.concat(in_data.to_pandas_dfs(), axis=1)
import scipy.stats as ss
print(ss.chi2_contingency(idf))


[RUN]버튼을 선택하여 결과를 확인합니다.


(1944.4561959955277, 0.0, 36, .....) 검정통계량(독립성 검정), p-value, dof(자유도=(12-1)*(4-1))


귀무가설을 기각하고 대립가설을 채택합니다. 가사는 작업구성과 차이가 있습니다.

2. 카이제곱 검정은 카이제곱 독립성(동질성) 검정과 적합도 검정 2개로 구분되네요( https://www.jmp.com 이하 이곳에서 가져옴)

3. 카이제곱 독립성 검정은 두 변수가 관련될 가능성 여부를 확인합니다. 여기에 범주형 또는 명목형 변수 2개에 대한 개수 값이 있습니다. 또한 두 변수가 관련이 없다고 가정합니다. 검정을 통해 이러한 가정이 타당한지 여부를 판정할 수 있습니다.

  • 영화 장르가 첫 번째 변수입니다. 두 번째 변수는 장르별로 관객들이 영화관에서 간식류를 구입했는지 여부입니다. 기본 전제(또는 통계 용어로 귀무가설)는 영화 장르와 관람객들의 간식류 구입 여부 사이에는 관련성이 없다는 것입니다. 영화관 사장은 영화관에 간식류 비축량을 추정하려고 합니다. 영화 장류와 간식류 구매 간에 관련이 없는 경우, 영화 장르가 간식류 판매에 영향을 미칠 경우보다 더 간단히 추정할 수 있습니다.

4. 카이제곱 적합도 검정은 표본 데이터가 특정 이론적 분포에서 추출된 것인지 여부를 확인합니다. 여러 데이터 값들이 표집된 집합이 있고 데이터 값의 분포 양상에 대한 가정이 내려져 있습니다. 카이제곱 적합도 검정은 데이터 값이 가정에 "충분히" 적합한지 또는 가정에 의문점이 있는지 판별하는 방법을 제공합니다.

  • 각 봉지마다 캔디가 100개씩 들어있고 5가지 맛 캔디가 고르게 담겨있는 캔디 봉지 10개 가 있습니다. 각 봉지에 맛별로 동일한 개수의 캔디가 들어 있습니다. 검정하려는 가설은 봉지마다 담긴 5가지 맛의 비율이 같다는 것입니다.

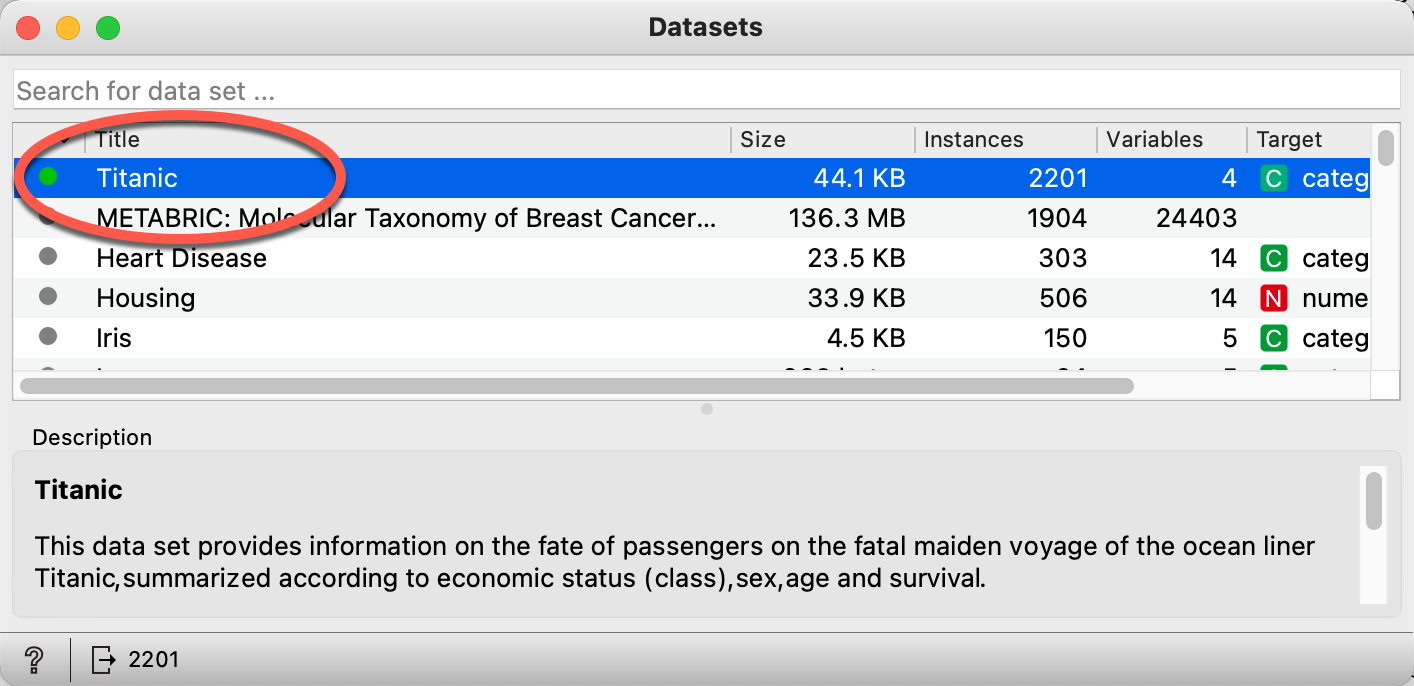
5. 오렌지의 데이터세트에 있는 타니타닉생존자 자료에서 남녀간의 생존여부의 차이가 있는지 카이제곱검정을 해봅니다.


6. Datasets위젯을 더블크릭하여  Titanic을 선택합니다.


6. Data Table위젯을 더블크릭하여 데이타의 구조를 살펴봅니다.


 7. Sieve Diagram(채 다이아그램)위젯을 오렌지 캔바스에 놓고 Datasets와 연결하고 더블크릭한후 아래와 같이 선택합니다.


8. 자료의 갯수가 2201개이고, 카이제곱검정값이  456.87이며, 피값은 0.05 이하입니다. 귀무가설을 기각하고 생존율은 성별에 유의하다고 판정합니다.  4개의 사각형 크기가 다르지요. 사각형 크기는 기대값이고 사각형안의 채(그리드, 그물)의 촘촘함은 관측치입니다.

성별에서 여성의 사각형이 적은 것은 탑승자중 여성의 비율이 낮은것이고, 파란사각형 안의 채(그리드)가 촘촘 한것은 실제 관특치가 많은 것을 보여줍니다. 반대로 남성의 탑승자는 많으나 위 빨강위처럼 채가 듬성듬성한 것은 생존자가 기대값보다 매우 적었다고 해석합니다.

2022년 4월 28일 목요일

Orange3로 통계강의 따라하기 04 (일원분산분석 Anova)

   Orange3를 엘리쌤과 인공지능에서 알게된후 Python 기초 통계를 공부하면서 최대한 Orange3로 따라하면서 통계도 공부하고, 오렌지도 공부하고 덩달아 파이썬도 익히는 시간을 갖기로 하였습니다.

섹션: 일원분산분석(Anova)을 오렌지로 따라해봅니다.

1. 인터넷상의 자료의 URL을 복사합니다. 다운 받은 다음 불러와도 됩니다. PlantGrowth.csv   이 자료에서 group 요인은 수준이 ctrl, trt1, trt2 세 개. 다시 말해 세 집단을 비교하는 것입니다.


2. 오렌지의 캔바스는 아래와 같이 파일과 박스플롯을 배치합니다. 

3. 파일 위젯의 URL에 붙여넣기하고 [Reload] 버튼을 선택합니다.
4. 박스플롯위젯을 선택하고 Variable = weight, Subgroup = group을 선택하고 오른쪽 화면에서 결과를 확입합니다. p값이 0.016으로 유의수준 0.05보다 적으므로 세집단간(요인간)에는 유의미한 차이가 있다고 판정합니다.

5. 데이터의 요인내 일관성이 있는지를 살펴보기위하여 Silhouette Plot위젯을 연결하여 결과를 확인하니 trt1에 2개의 자료가 특이하군요.
6. 해서 정규성검증을 해봅니다. 파이썬스크립트를 캔바스에 놓고 연결을 합니다. (2번째 요인만 확인 합니다)


import pandas as pd
from Orange.data.pandas_compat import table_from_frame,table_to_frame
import scipy.stats as ss
df = pd.concat(in_data.to_pandas_dfs(), axis=1)
trt1 = df.weight[df['group']==1]
print(ss.shapiro(trt1))


Running script:

ShapiroResult(statistic=0.9304108619689941, pvalue=0.451945960521698)


7. p값이 0.45 입니다. 귀무가설을 채택합니다. 즉 자료가 정규성을 크게 벗어났다고 보기 어렵다.


8. 등분산성은 파이썬스크립트를 이용해 아래의 코드로 확인 할 수 있습니다.

레빈 검증과 바틀렛 검증의 코드입니다.

scipy.stats.levene(
    idf.weight[df.group == 0],
    idf.weight[df.group == 1], df.weight[df.group == 2] )     
scipy.stats.bartlett(
    idf.weight[df.group == 0],
    idf.weight[df.group == 1], df.weight[df.group == 2] )


Orange3로 통계강의 따라하기 03 (단일표본, 독립표본 t-test의 논리)

   Orange3를 엘리쌤과 인공지능에서 알게된후 Python 기초 통계를 공부하면서 최대한 Orange3로 따라하면서 통계도 공부하고, 오렌지도 공부하고 덩달아 파이썬도 익히는 시간을 갖기로 하였습니다.

1.0 단일표본 t-test


1.1 Crate Table Widget

1.2 Edit Domain Widget

1.3 distributions widget
1.4 Python Script

Ttest_1sampResult(statistic=array([-1.07107994]), pvalue=array([0.31201445]))

평균이 90이다.


2.0 독립표본 t-test

2.1 두 집단 dat_M와 dat_F가 있음

dat_M = [117, 108, 105, 89, 101, 93, 96, 108, 108, 94, 93, 112, 92, 91, 100, 96, 120, 86, 96, 95]
dat_F = [121, 101, 102, 114, 103, 105, 101, 131, 96, 109, 109, 113, 115, 94, 108, 96, 110, 112, 120, 100]

2.2  두 집단의 평균 차이가 통계적으로 유의미한지 t-검증

import scipy.stats

scipy.stats.ttest_ind(dat_M, dat_F, equal_var=False)
Ttest_indResult(statistic=-2.670573872669349, pvalue=0.01108318824471652)

2.3. 파이썬에서는 [2]와 같이 하면 p값이 0.05 보다 적으므로 귀무가설을 기각하여 두 집단간의 차이는 유의미 하다고 판단합니다. 오렌지에서는 할 수 있는 위젯이 없는 것 같더군요.

3.0 이번에는 오렌지에서 파이썬스크립트를 이용합니다. 아래 그림과 같이 위젯을 배치&연결합니다.


3.1 Create Table

3.2 스크립터에 아래와 같이 입력합니다.

import pandas as pd
from Orange.data.pandas_compat import table_from_frame,table_to_frame

df = table_to_frame(in_data)
df = df.stack().reset_index()
out_data = table_from_frame(df)


3.3 Data Table에서 컬럼단위 데이터가 스택되었슴을 확인합니다.


3.4. Distributions widget에서 비교합니다.


3.5 Box Plot Widget . p값이 0.05보다 적네요. 그런데 계산값이 조금 차이가나네요. 공분산 때문인 것 같네요.


Orange3로 통계강의 따라하기 02 (평균, 표준편차, 분산, 사분위간 범위)

  Orange3를 엘리쌤과 인공지능에서 알게된후 Python 기초 통계를 공부하면서 최대한 Orange3로 따라하면서 통계도 공부하고, 오렌지도 공부하고 덩달아 파이썬도 익히는 시간을 갖기로 하였습니다.

섹션3~4 평균, 표준편차, 분산, 사분위간 범위를 오렌지로 따라해봅니다.

x = [1, 1, 2, 3, 3, 3, 4, 5, 5, 7]

1. 이번에는 구글시트를 이용하여 자료를 입력하고 가져오기를 합니다. File 위젯을 사용합니다. 크롬 익스플러에서 새탭을 연다음 아래 그림처럼 1, 2, 3 하여 스프레드시트를 열어 데이터를 입력합니다.


2. 공유를 선택합니다.

3. 링크를 생성하고 복사합니다.

4. 오렌지에서 Google Sheets 또는 File 위젯을 캔바스에 떨구고> 복사한 URL을 붙여넣기합니다.

5. Box plot 위젯을 캔바스에 떨구고 연결한다음 

6. 더블크릭하여 결과를 확인합니다.

7. 평균: 3.40, 표준편차: 1.8, 최소값: 1, 최대값: 7, 중위수: 3, 1Q: 2.50, 3Q: 4.50, 범위(IQR * 1.5)를 확인.


Orange3로 통계강의 따라하기 01 (도수분포표와 히스토그램)

 Orange3를 엘리쌤과 인공지능에서 알게된후 Python 기초 통계를 공부하면서 최대한 Orange3로 따라하면서 통계도 공부하고, 오렌지도 공부하고 덩달아 파이썬도 익히는 시간을 갖기로 하였습니다.

섹션2 도수분포표와 히스토그램을 오렌지로 따라해봅니다.

0. 데이터를 오렌지에 입력하는 방법은 인터넷환경에서 구글시트, 로칼컴퓨터에서 텍스트에디터, 오렌지에서 파이썬스크립위젯, 오렌지에서 Create Table 위젯을 사용 할 수 있겠네요. Create Table 위젯을 사용해봅니다. 혹시   Create Table 위젯이 안보이시면 [Options > Add Ones...] 한 후 아래와 같이 설치하시면 됩니다.


I. 범주 변수 
blood = ['A', 'A', 'A', 'B', 'B', 'AB', 'O']
1. Create Table을 캔바스에 올려놓고 더블크릭한 후 아래와 같이 입력합니다.

2. Distributions 위젯을 캔바스에 올려 놓고 > 연결하고 > 더블크릭하면 아래와 같은 결과를 볼 수 있습니다.  
3. 특성(속성, feature) 이름이 "1"로되어 있어 눈에 거슬리면 Edit Domain 위젯을 중간에 삽입하고 아래 그림처럼 변수이름을 바꾸어 주면 됩니다.
4. 최종 결과입니다. (왜이렇게 복잡하게 하냐구요? 오렌지의 위젯을 익힐 수 있잖아요.)

II. 연속 변수
x = [1, 1, 1, 2, 3, 5, 5, 7, 8, 9]
1. 위와 같은 방법으로 하면 이렇게

2. 교제에서는 범주로 나누었는데 이것은 조금 어렵겠네요. 아래와 같이 Preprocess 위젯을 중간에 삽입하고
3. Discretize Continuous Variables를 선택한다음 구간을 4으로 나누면 

4. 결과가 아래와 같습니다.

델파이의 부활(Antigravity와의 만남)?

 델파이 프로그램을 사용하여 개인적으로 필요한 프로그램을 생성해 왔는데, 얼마전부터 파이썬으로 옮겨갔다.  그런데 Google 의 Antigravity를 만나고 나서 델파이에 대한 미련을 버리지 못해  제미나이가 Delphi이에 대한 학습도 엄청 했을...