2022년 5월 10일 화요일

Orange3에서 Logistic Regression 분류

0. 혼자 공부하는 머신러닝+딥러닝에 있는 fish.csv 자료를 이용하여(이곳에서 다운로드) Logistic Regression 분류를 해봅니다.

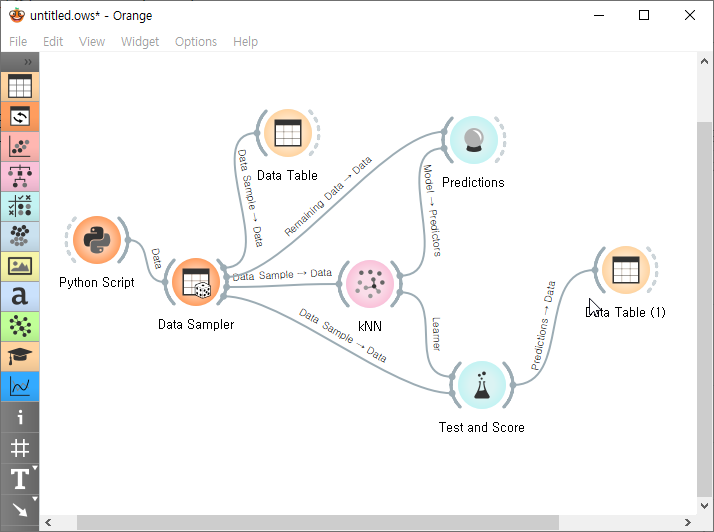
1. 오렌지의 캔바스를 아래와 같이 구성하고 


2. File Widget을 선택하여 다운받은 파일을 지정하고 >  [Reload] 버튼을 선택합니다.


3. Data Sampler Widget을 선택하여 훈련(Train)데이타(85%)와 검증(Test)데이타(15%)로 분류합니다.


4. Test Prediction 과 Data Table을 선택하여 결과를 확인합니다. 


5. Data Table에서 Feature 클라스별로 계수가 있음을 확인하시고, Test Prediction 의 왼쪽 박스에서 계산결과를 확인합니다. 가장 높은 것으로 분류합니다. 이 계수를 딥러닝에서 조절해 가면서 학습을 한다고 생각하면 편합니다.


최근접 이웃(K-Nearest Neighbors) 분류 2

1. 앞의 최근접 이웃 모델1에 Create Instance Widget을 추가하고 


2. x1 = 25, x2 = 150인 자료를 추가합니다.


3. Data Sampler Widget은 적당하게


4. Predictions Widget을 살펴보면

추가된 x1 = 15, x2 = 150을 0.4(<0.5)로 빙어로 판단했습니다. 이는 스케일의 문제입니다.

5. KNN에 Preprocess를 연결하고 표준화를 선택합니다.


6. Data Sampler Widget에서 Sample Data버튼을 수회 누르면 서 Predictions Widget을 살펴보면 Source ID가 created로 되어있는 것의 kNN 결과를 보면 0.8(>0.5)을 나타냅니다. (1 = 도미)


7. Preprocess Widget을 연결하는 방법은 2가지가 있으니 참고하십시요.


최근접 이웃(K-Nearest Neighbors) 분류 1

0. 최근접 이웃 알고리즘은 우리가 예측하려고 하는 임의의 데이터와 가장 가까운 거리의 데이터 K개를 찾아 다수결에 의해 데이터를 예측하는 방법이다.


1. 오렌지의 캔바스에 위젯을 위치시키고 연결합니다.


2. 혼자 공부하는 머신러닝+딥러닝에 있는 도미와 빙어자료를 이용하였습니다. 파이썬 스크립트를 더블크릭하고 아래 사항을 입력한다음 [RUN]버튼을 선택합다.

import numpy as np
from Orange.data import Table, Domain, ContinuousVariable, DiscreteVariable

iclass = ContinuousVariable("y")
domain = Domain([ContinuousVariable("x1"),
                 ContinuousVariable("x2")], iclass)

ix = [25.4, 26.3, 26.5, 29.0, 29.0, 29.7, 29.7, 30.0, 30.0, 30.7, 31.0,\
      31.0, 31.5, 32.0, 32.0, 32.0, 33.0, 33.0, 33.5, 33.5, 34.0, 34.0,\
      34.5, 35.0, 35.0, 35.0, 35.0, 36.0, 36.0, 37.0, 38.5, 38.5, 39.5,\
      41.0, 41.0, 9.8,  10.5, 10.6, 11.0, 11.2, 11.3, 11.8, 11.8, 12.0,\
      12.2, 12.4, 13.0, 14.3, 15.0]
iy = [242.0, 290.0, 340.0, 363.0, 430.0, 450.0, 500.0, 390.0, 450.0,\
      500.0, 475.0, 500.0, 500.0, 340.0, 600.0, 600.0, 700.0, 700.0,\
      610.0, 650.0, 575.0, 685.0, 620.0, 680.0, 700.0, 725.0, 720.0,\
      714.0, 850.0, 1000.0, 920.0, 955.0, 925.0, 975.0, 950.0, 6.7,\
      7.5, 7.0, 9.7, 9.8, 8.7, 10.0, 9.9, 9.8, 12.2, 13.4, 12.2, 19.7,\
      19.9]
arr = np.column_stack((ix, iy))
target = np.concatenate((np.ones(35), np.zeros(14)))
out_data = Table.from_numpy(domain, arr, target)

3. Data Sampler 위젯에서 훈련데이터와 검증데이터로 나눔니다.


4. Test and Scode Widget에서 확인합니다.

MSE = 0 이고 R^2 = 1.0으로 매우 고무적이네요.

5. Predictions Widget을 선택하여 확인합니다.


예측도 정확합니다.


2022년 5월 9일 월요일

ROC 곡선의 이해 (Receiver Operating characteristic Curve)

 1. 오차행렬 구성

돌아서면 잊버버리는 표입니다. 예측은 양성(P), 음성(N)으로 하고, 실제결과는 맞음(T), 틀림(F)로 기억하면 쉽더군요. 부호표시는 뒤에서부터합니다.
양성이라고 예측했는데 양성으로 맞았으니(TP = A), 틀렸으면(FP)
음성이라고 예측했는데 음성으로 맞았으니(TN = B), 틀렸으면(FN)

2. 민감도(Sensitivity = Recall)
민감도는 '실제 양성 대 맞춘 양성의 비율'을 의미한다. 
위에서 실제 양성인 것은 TP와 FN이다. 양성으로 예측해서 맞췄거나 음성으로 예측했는데 틀린 경우를 합친 것이 실제 진단 결과가 양성인 것이 된다. 
그리고 여기서 맞춘 양성은 TP만 해당하므로 이를 비율로 표현한 민감도는 다음과 같이 구해진다.

3. 특이도(Specificity)
특이도는 '실제 음성 대 맞춘 음성의 비율'을 의미한다. 
위에서 실제 음성인 것은 TN과 FP이다. 음성으로 예측해서 맞췄거나 양성으로 예측했는데 틀린 경우를 합친 것이 실제 진단 결과가 음성인 경우에 속한다. 
그리고 여기서 맞춘 음성은 TN만 해당하므로 이를 비율로 표현한 특이도는 아래와 같이 계산된다.

4. ROC곡선(Receiver Operating characteristic Curve)
위양성률(1-특이도)을 x축으로, 그에 대한 실제 양성률(민감도)을 y축으로 놓고 그 좌푯값들을 이어 그래프로 표현한 것이다. 일반적으로 0.7~0.8 수준이 보통의 성능을 의미한다. 
0.8~0.9는 좋음, 0.9~1.0은 매우 좋은 성능을 보이는 모델이라 평가할 수 있다. (사족: X축은 적을수록 좋고 Y축은 클수록 좋다, 즉 같은 TP 가로로 수평선을 그렸을때 FP가 적을 수록(1<2<3 정확하겠죠, 수직선을 그은 다면 TP가 클수록(4<5<6) 정확하겠지요)
5. 정확도(Accuracy)
전체 데이터에서 모델이 옳게 판단한 비율

6. 오렌지3에서의 ROC 위젯예제,  File자료는 iris입니다.


7. Test and Score


8. Precision 정밀도(양성이라고 판단한 것중 양성의 비율 = 정밀한 의사 겠지요)

8. AUC의 의미
AUC는 'Area Under Curve'의 약자로 ROC분석을 통해 그려지는 '곡선 밑의 면적'을 의미한다.  AUC는 0.5보다 커야 하고 AUC 면적이 클수록 해당 검사모델의 정확도가 높다

9. settosa의 정확도 = 0.942


10. versicolor의 정확도 = 0.482, ROC 곡선은 왼쪽위 상단에 붙어야 정확도가 있는 모델이다.


2022년 5월 8일 일요일

오렌지3에서 ARIMA로 삼성전자 주식예측 해보기

 오렌지를 이용한 머신러닝으로 들어가기전의 마지막 단계로 ARIMA 시계열분석을 해봅니다. 저는 통계전문가가 아니어서 자세한 내용설명은 못해드리고 구현만 해봅니다.

1. 오렌지에 위젯을 아래와 같이 배치 합니다.


2. Yahoo Finance 위젯을 더블크릭하고 Ticker 드롭박스에 삼성전자의 종목번호를 입력합니다. 뒤에 .KS를 붙이시면 됩니다. 국내에서 사용하는 종목번호+ .KS 입니다. 삼성전자 = 005930.KS, LG화학 = 051910.KS등 입니다. 처음에는 Ticker에 있는 것을 선택할 줄만 알았지 키보드로 입력해도 되는 줄 모르고 삽질 좀 했습니다.

3. Data Table 위젯에서 어제의 종가까지 불러왔음을 확인합니다.


4. Select Rows 위젯을 더블크릭하여 어제 자료를 제외하고 선택합니다. 이는 예측을 해보고 예측된 값을 비교하기 위해섭니다( 훈련데이터와 시험데이터로 구분하는 것이지요)
 

4. 그래프를 그려서 확인해보면 추세가 있네요. 추세를 제거하기위해 Difference 위젯으로 처리하고

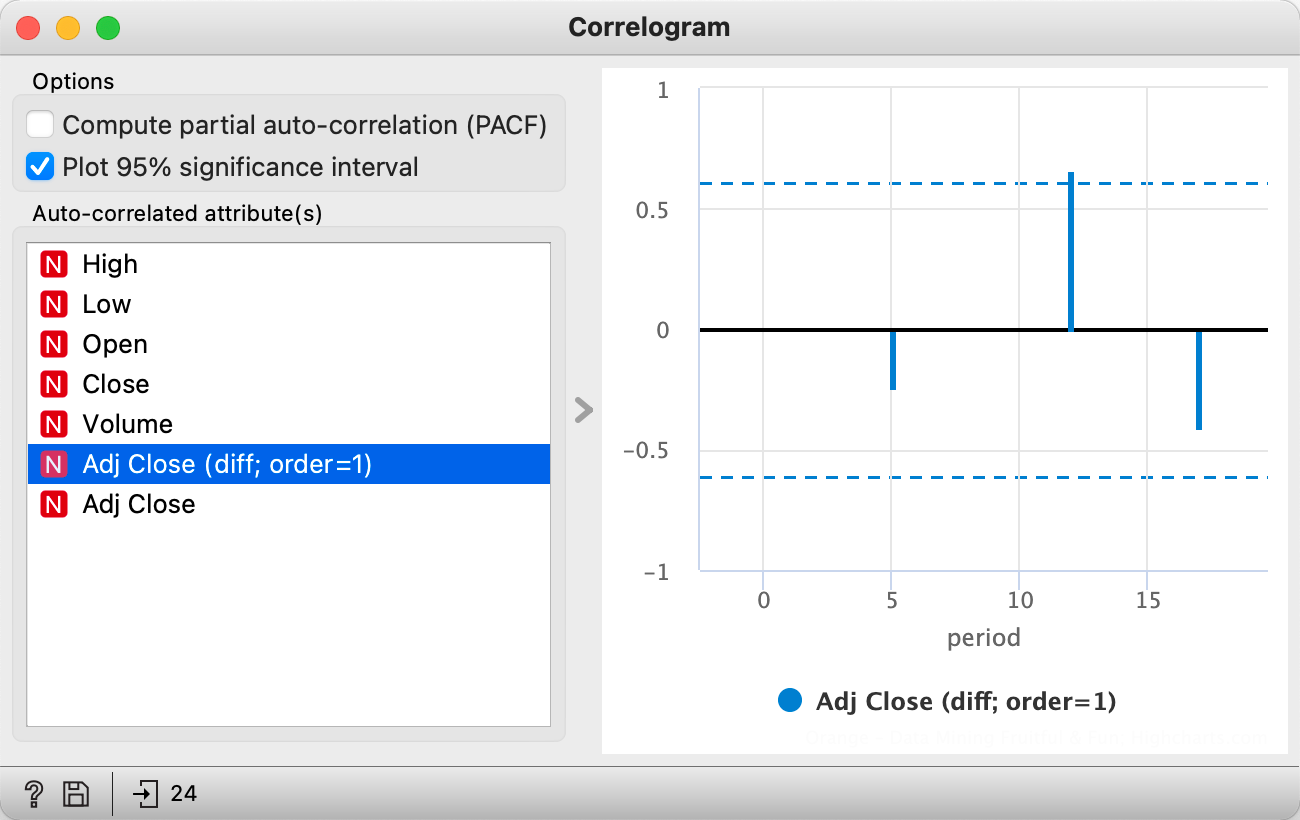
5. Correlogram에서 결과를 확인해봅니다. 95% 신뢰구간에 들어왔네요.

6. Line Chart 위젯을 하나 추가하여 결과를 확인할 수 도 있습니다. (위 캔바스 전체 이미지에는 빠짐, 추가하려면 Correlegram에 연결). 추세가 없어졌슴을 확인합니다.
그래프를 2개 나오게 하려면 Add plot 버튼을 선택하면 됩니다.

5. ARIMA Model 위젯의 설정은 아래와 같습니니다.

6. Model Evaution 위젯을 더블크릭하여 RMSE 와 R^2(결정계수) 확인합니다. 믿을만 하지 못하네요.


(1)은 교차검정방법이고 (2)는 샘플링방법입니다.

7. Line Chart 위젯에서 확인합니다.


8. 예측된 결과입니다. FOMC 영향을 받은 것을 고려하면..... 실제 5월6일 조정종가는 66500원 인것과 비교해보십시요. 

2022년 5월 7일 토요일

오렌지3에서 한국 Wikipedia에서 검색한 자료를 이용한 Word Cloud

 오렌지3에서 간단하게 Wikiprdia 자료를 읽어 Word Cloud를 해봅니다. 오렌지 예전버전에는 Text Mining에 Wikipedia 자료를 읽어 올 수 있는 위젯이 있었는데 3버전에서는 없어졌네요. 오렌지를 사용하지 않고는 이처럼 환경설정이 복잡해요.

1. 위젯을 아래와 같이 배치합니다.


2. 파이썬스크립트를 아래와 같이 수정하고 [RUN]버튼을 선택합니다.

import Orange.data.pandas_compat as p
import orangecontrib.text.wikipedia_api as wiki
api = wiki.WikipediaAPI()
corpus = api.search('ko',['이재명', '변호사'])

out_object = corpus

위키피디아에서 자료를 검색해 읽어오는데 상당히 긴시간이 소요되네요. 바람개비가 멈출대까지 기다리세요.

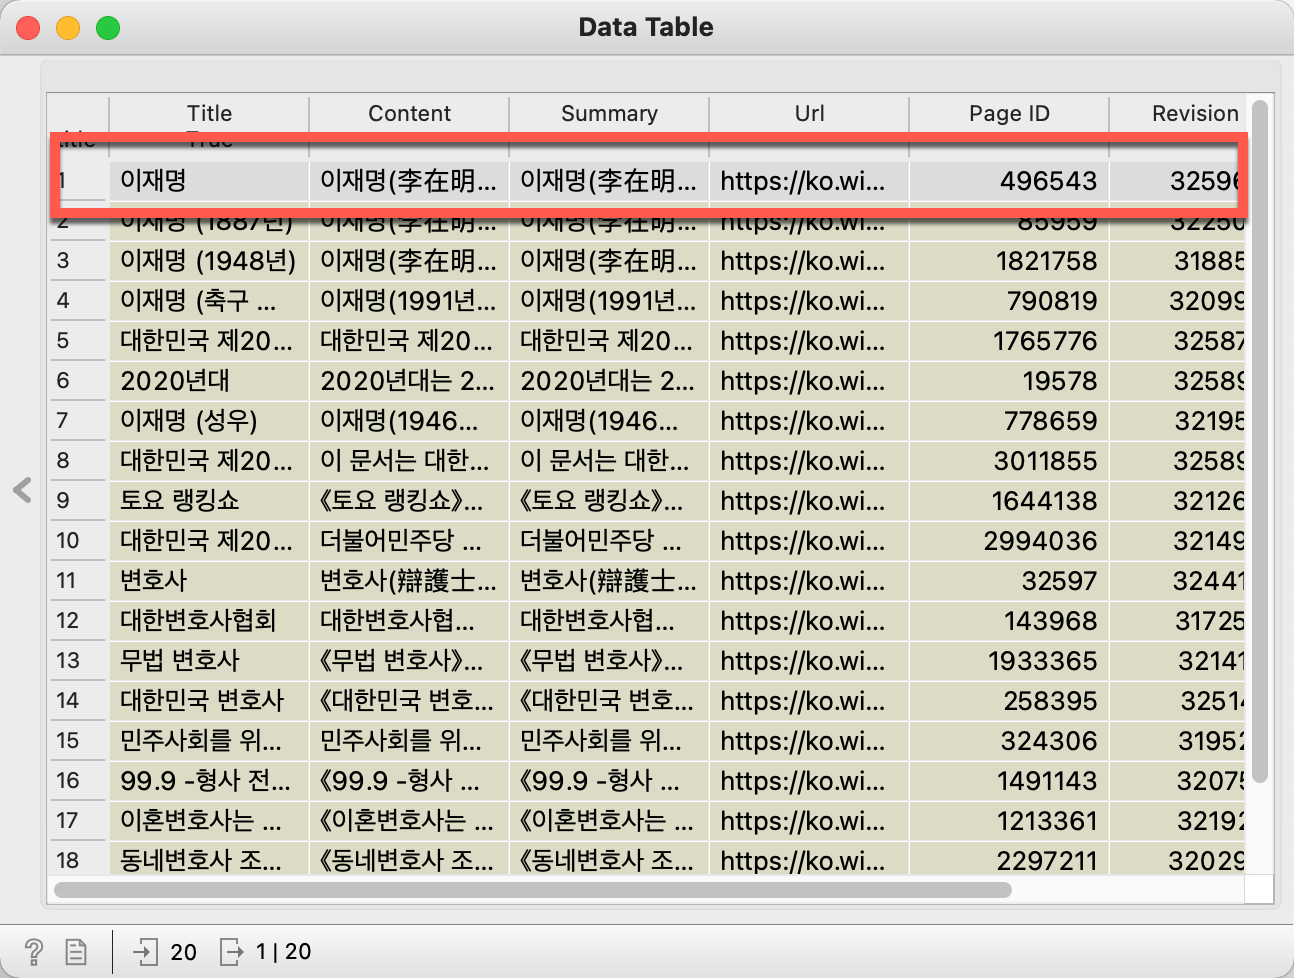
3. 데이타테이블위젯에서 첫행을 선택하고 


3. Save Data 위젯을 선택하여  적당한 폴더를 만들고 그곳에 저장합니다.(저는 폴더 이름을 doc라고 했습니다) 

4. 파인더(맥), 탐색기(윈도우)를 이용하여 해당파일의 확장자를 .txt라고 바꾸어 주고 앞부분과 뒷부분의 불필요한 내용은 삭제를 합니다.

5. Import Documents 위젯을 선택하여 파일을 저장한 폴더를 선택합니다.


6. Corpus Viewer를 선택하여 내용을 확인합니다.


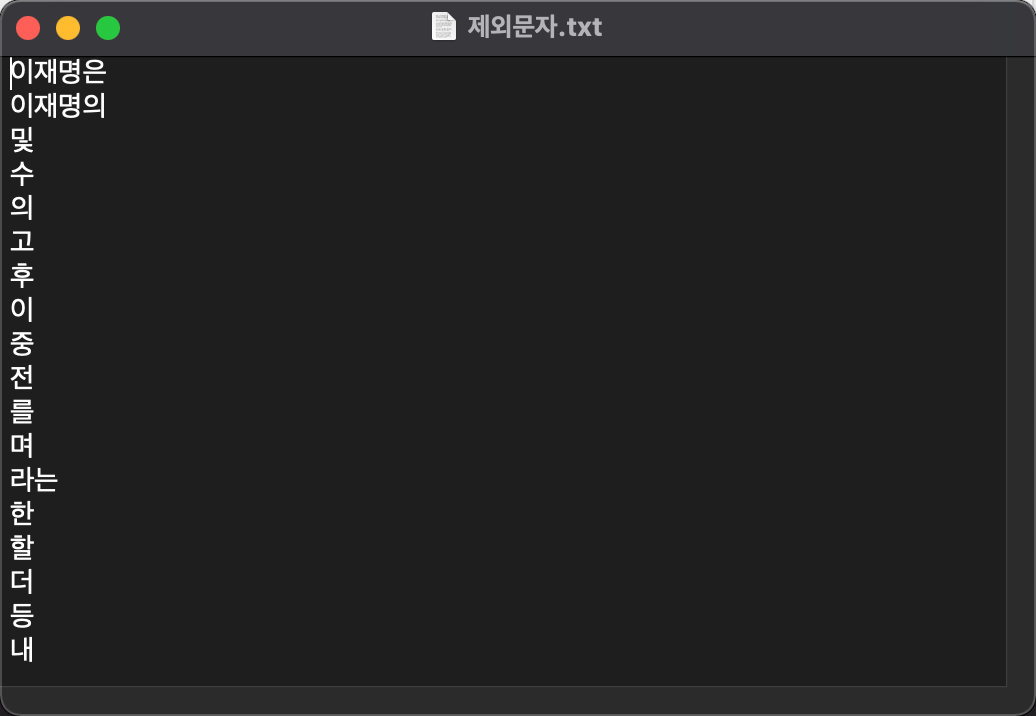
7. Preprocess Text를 선택하여 아래 그림과 같이 Tokenization 과 Filtering을 추가한후 설정을 합니다. 제외문자는 텍스트에디터(맥) 노트패드(윈도우)등으로 아래와 같이 작성하여 저장해둡니다(저는 doc폴더에 저장하였습니다).


8. Word Cloud를 선택하여 내용을 확인합니다.

오렌지3에서의 시계열분석 (Time-series Analysis) ARIMA

 1. 시계열분석

시간에 따라 변화되는 자료의 패턴을 밝혀 가까운 미래를 예측하는 방법이다. 시계열분석을 위해서는 시계열 데이터가 준비돼야 한다. 시간의 경과만 한 축(𝑥)을 구성하는 것이 아니라 시간 경과가 일정한 시차로 정돈되어 있을 때 이를 시계열 데이터로 본다.

2. 시계열분석 모형

시계열분석은 기본적으로 선형 예측을 전제로 한다. 시간을 가로축에 놓은 회귀분석이라고 할 수 있다. 뚜렷한 상관관계를 바탕으로 하는 선형 회귀분석은 미래는 과거를 닮는다는 전제를 바탕으로 시계열분석으로 응용되었다.

<파이썬을 활용한 데이터분석 사례, 심사평가원>

3. 작성중...


오즈비 (Odds Ratio = 승산비)에서 로지스틱으로

1. 오즈비 

사건이 발생할 확률이 발생하지 않을 확률에 비해 몇배 더 높은가를 설명하는 개념

 이미지 출처 : https://m.blog.naver.com/y4769/221851780608

2. 오즈비 계산 예

A : 97명 - 코로나 환자와 접촉 후, 코로나에 감염됨
B : 307명 - 코로나 환자와 접촉 후, 코로나에 감염되지 않음
C : 200명 - 코로나 환자와 접촉하지 않았지만, 코로나에 감염됨
D : 1409명 - 코로나 환자와 접촉하지 않았고, 코로나에 감염되지 않음

Odds Ratio(OR) = 136673 / 61400 = 2.2로 계산된다.

따라서, 코로나 환자와 접촉한 사람은 접촉하지 않은 사람보다 코로나 감염이 될 가능성이 2.2배 높다고 할 수 있다.

3. 로짓(logit) 변환: 오즈비에 log 함수 적용한 것으로 로짓을 대상으로 회귀분석을 적용한 것이 로지스틱 회귀분석이 된다.

logit = log( p / 1-p )

2022년 5월 6일 금요일

오렌지3에서 Sqlite 데이터베이스 읽어오기

 Sqlite 데이터베이스는 데이터베이스 서버가 없는 파일형태의 데이터베이스입니다. 하나의 데이터베이스에는 여러개의 테이블이 있고 각각의 테이블은 레코드로 구성되어 있습니다.

오렌지3에서 Sqlite데이터베이스에 자료를 입력하는 경우는 별로 없을 것이고, 누군가(시스템, 기계, 여론조사 디비등등)가 만들어 놓은 자료를 접근하여 읽어오기만 하면될것입니다. (나중에 기회되면 쓰는 것도 다루어 보죠)

1. 먼저 Sqlite 데이터 베이스를 (이곳에서 다운로드) 에서 다운받아 컴퓨터의 적당한 곳에 저장해 둡니다.

2. 파이썬스크립트위젯과 데이터테이블위젯을 아래와 같이 오렌지 캔바스에 배치합니다.


2. 파이썬스크립트를 더블크릭하고 아래코드를 붙여넣기하고 [RUN] 버튼을 선택합니다.

import sqlite3
import Orange.data.pandas_compat as p

conn = sqlite3.connect('exam.sqlite', isolation_level=None)
iSql = 'select * from table2 where date >= "2010-01-01" order by date'
idf = p.pd.read_sql(iSql, conn)
out_data = p.table_from_frame(idf)
 
3. 데이터테이블위젯을 더블크릭하여 확인합니다.

3. 이제 스크립트를 설명합니다.
  • 1행: 당연히 sqlite 관련 객체를 불러오기위하여 import 하여야 겠지요.
  • 2행: pandas를 이용해 데이터베이스 내용을 읽어와야 하기때문에 오렌지3 설치될때 같이 설치된 pandas_compat를 import 해옵니다.
  • 3행: 데이타베이스와의 연결을 위한 객체를 생성합니다. (첫 인수로는 Sql 파일이 있는곳과 파일이름, commit 단계)
  • 4행: SQL 명령어
  • 4행: pandas의 read_sql을 이용하여 SQL 명령어를 연결객체에 전달합니다. 그결과가 idf에 DataFrame 형태로 보관됩니다.
  • 5행: DataFrame을 위젯의 출력으로 변환합니다.

4. SQL 명령어를 간단히 설명합니다.
  • select * from은 무조건이라고 생각하면 됩니다. 뒤에 조건에서 지정한 모든(*) 자료를 읽어오라는 것입니다.
  • exam.sqlite 라는 것이 데이타베이스입니다. 엑셀로 따지면 파일이름이겠지요.
  • table1은 엑셀에는 시트가 여럿 있듯이 데이타베이스에도 테이블이 여러개 있으며 그중 table2 에서 읽어오라는 것입니다.
  • where는 그다음의 조건에 맞는 것을 읽어오라는 것이고
  • date >= "2010-01-01"은 엑셀로 따지면 컬럼이름과 같은 의미의 date 라는 필드(컬럼)에서 "2010-01-01" 이후 자료를 지정한 것입니다.
  • order by date는 자료를 읽어 가져올때 date 라는 필드(컬럼)의 오름차순 정렬을 의미합니다.

5. SQL 명령부분은 "select * from table1" 만하고 오렌지의 다른위젯을 이용해 데이터를 취사 선택 정렬할 수 있습니다.  또한 읽기전용이기에 conn의 "isolation_level=None" 부분도 생략할 수 있습니다.


델파이의 부활(Antigravity와의 만남)?

 델파이 프로그램을 사용하여 개인적으로 필요한 프로그램을 생성해 왔는데, 얼마전부터 파이썬으로 옮겨갔다.  그런데 Google 의 Antigravity를 만나고 나서 델파이에 대한 미련을 버리지 못해  제미나이가 Delphi이에 대한 학습도 엄청 했을...